

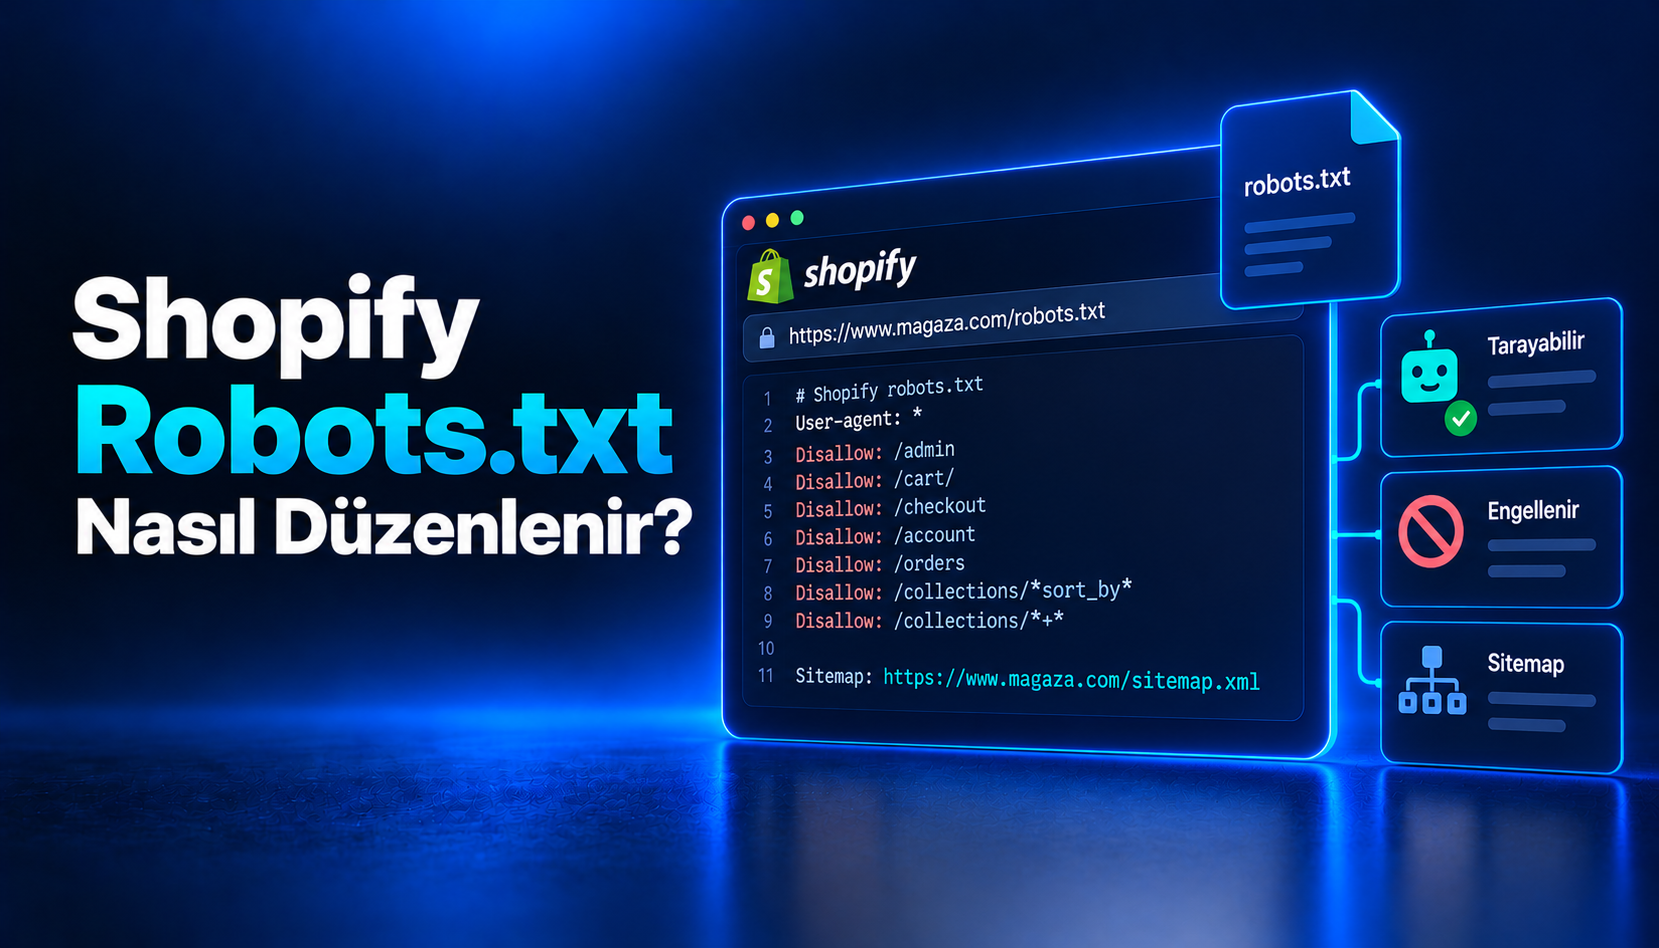

Shopify robots.txt dosyası, arama motoru botlarına mağazanızdaki hangi URL’leri tarayabileceklerini ve hangilerini taramamaları gerektiğini bildiren kontrol dosyasıdır. Shopify bütün mağazalarda varsayılan bir robots.txt dosyası otomatik olarak oluşturur ve bu dosya çoğu mağaza için SEO açısından yeterlidir. Shopify da varsayılan robots.txt yapısının büyük çoğunluk için uygun olduğunu, yalnızca özel ihtiyaçlarda robots.txt.liquid üzerinden düzenleme yapılmasını öneriyor.
Bu nedenle Shopify robots.txt düzenleme işlemine ilk yaklaşım mümkün olduğunca fazla URL engellemek olmamalıdır. Yanlış bir Disallow kuralı ürün, koleksiyon veya içerik sayfalarının taranmasını engelleyebilir ve organik görünürlüğe ciddi zarar verebilir.
Asıl yapılması gereken, önce mevcut robots.txt dosyasının neyi engellediğini anlamak, gerçekten bir crawl problemi olup olmadığını doğrulamak ve yalnızca gerekli durumda kontrollü düzenleme yapmaktır.
Robots.txt Nedir?
Robots.txt, sitenin kök dizininde bulunan bir metin dosyasıdır.
Shopify mağazasında genellikle şu adresten erişilir:
https://domaininiz.com/robots.txt
Dosya içerisinde farklı arama motoru botları için kurallar bulunabilir.
Örneğin:
User-agent: *
Disallow: /admin
Disallow: /cart/
mantığı, tüm botların admin ve cart gibi belirli URL gruplarını taramamasını ister.
Shopify robots.txt dosyasının user-agent, allow/disallow kuralları ve isteğe bağlı sitemap tanımlarından oluştuğunu belirtiyor.
Crawling ile Indexing Aynı Şey mi?
Hayır.
Bu ayrım robots.txt düzenlerken kritik öneme sahiptir.
Crawling, Googlebot gibi arama motoru botlarının sayfayı ziyaret edip içeriği ve kodu incelemesidir.
Indexing ise sayfanın arama sonuçlarında görünmeye uygun hale gelmesidir.
Shopify da robots.txt dokümantasyonunda bu iki sürecin birbirinden farklı olduğunu ve bir sayfanın robots.txt ile taranması engellense bile başka kaynaklardan keşfedilerek indexlenebileceğini belirtiyor.
Bu nedenle robots.txt dosyasını bir noindex aracı gibi kullanmak doğru değildir.
Shopify Varsayılan Robots.txt Dosyası Ne İşe Yarar?
Shopify’ın varsayılan robots.txt dosyası mağazadaki gereksiz veya kullanıcıya özel URL’lerin crawler tarafından taranmasını sınırlar.
Örneğin Shopify’ın güncel varsayılan yapısında şu tip alanlar engellenebilir:
/admin/cart//checkout/checkouts//account/orders- bazı filtreli koleksiyon URL’leri
sort_byparametreli koleksiyon URL’leri
Shopify, Disallow: /collections/*+* gibi kurallarla filtrelenmiş koleksiyonların, Disallow: /collections/*sort_by* ile de yalnızca ürün sıralamasını değiştiren URL’lerin gereksiz taranmasını azaltıyor.
Bu kurallar duplicate URL’ler ve kullanıcıya özel sayfalar yerine arama motorlarının ürün, koleksiyon, blog ve sayfa içeriklerine odaklanmasına yardımcı olur.
Shopify Robots.txt Dosyasını Düzenlemek Gerekir mi?
Çoğu mağazada hayır.
Shopify’ın resmi yardım merkezinde varsayılan robots.txt dosyasının çoğu mağaza için yeterli olduğu açıkça belirtiliyor.
Ancak bazı özel durumlarda düzenleme gerekebilir.
Örneğin özel bir uygulamanın binlerce gereksiz crawl URL’si üretmesi, belirli bir crawler’ın engellenmesi, özel sitemap eklenmesi veya özel bir teknik SEO mimarisi oluşturulması gibi durumlarda robots.txt.liquid kullanılabilir.
Ancak Search Console’da birkaç gereksiz URL gördüğünüz için robots.txt değiştirmek doğru değildir.
Önce problemi canonical, noindex, redirect veya site mimarisiyle çözmenin daha doğru olup olmadığı değerlendirilmelidir.
Shopify robots.txt.liquid Nedir?
Shopify, varsayılan robots.txt dosyasının kendisini doğrudan değiştirmenize izin vermez. Bunun yerine tema içerisinde robots.txt.liquid adında özel bir template oluşturabilirsiniz.
Bu template sitenin /robots.txt çıktısını üretir.
Buradaki önemli avantaj, Shopify’ın varsayılan kurallarını tamamen kaybetmeden kendi kurallarınızı ekleyebilmenizdir.
Shopify da Liquid üzerinden mevcut default rule gruplarına ekleme veya çıkarma yapılmasını öneriyor. Bu yöntem Shopify’ın robots.txt yapısını gelecekte güncel tutmaya devam etmesini sağlar.
Shopify Robots.txt Nasıl Düzenlenir?
Shopify Admin içerisinde:
Online Mağaza > Temalar
alanına gidin.
Yayınlanan temanın yanındaki menüden:
Kodu Düzenle
seçeneğini açın.
Daha sonra:
Yeni Şablon Ekle
seçeneğine tıklayın.
Template türü olarak:
robots
seçin.
Shopify otomatik olarak:
robots.txt.liquid
dosyasını oluşturur.
Bundan sonra istediğiniz ek kuralları bu dosya içerisinde yönetebilirsiniz.
Robots.txt Dosyasını Tamamen Düz Metinle Değiştirmek Doğru mu?
Genellikle hayır.
Teknik olarak robots.txt.liquid içeriğini tamamen silebilir ve manuel düz metin kuralları yazabilirsiniz. Ancak Shopify bunu güçlü şekilde önermiyor.
Bunun nedeni, Shopify’ın gelecekte varsayılan SEO kurallarında yaptığı iyileştirmelerin manuel robots.txt dosyanıza otomatik olarak yansımamasıdır.
Daha sağlıklı yöntem mevcut Shopify rules çıktısını koruyup yalnızca gerekli ilave kuralları eklemektir.
Mevcut Shopify Kurallarını Koruyarak Ek Kural Nasıl Eklenir?
En güvenli yaklaşım Shopify’ın varsayılan rule gruplarını Liquid ile döndürüp ardından kendi kurallarınızı eklemektir.
Örneğin mantık olarak:
{% for group in robots.default_groups %}
  {{- group.user_agent -}}

  {% for rule in group.rules %}
    {{- rule -}}
  {% endfor %}

  {% if group.sitemap != blank %}
    {{ group.sitemap }}
  {% endif %}
{% endfor %}
yapısının üzerine belirli custom kurallar eklenebilir.
Ancak mağazanın ihtiyacına göre doğru Liquid yapısını kullanmak gerekir. Shopify’ın developer dokümantasyonu bunun için robots.default_groups, rule nesneleri ve sitemap öğeleriyle çalışma yöntemlerini açıklıyor.
Kod düzenlemeden önce tema yedeği almak önemlidir.
Belirli Bir URL Robots.txt ile Nasıl Engellenir?
Örneğin aşağıdaki özel URL yapısını crawler’ın taramasını istemediğinizi varsayalım:
/pages/test-page
robots.txt içerisinde ilgili user-agent grubuna:
Disallow: /pages/test-pageeklenebilir.
Ancak bu URL zaten Google indexindeyse yalnızca robots.txt ile engellemek URL’yi arama sonuçlarından kaldırmayabilir.
Google sayfayı başka linklerden keşfetmişse URL indexte kalabilir.
Bu nedenle gerçek hedef indexten kaldırmaksa robots.txt yerine noindex daha doğru olabilir.
Belirli Bir Klasör Nasıl Engellenir?
Örneğin özel bir uygulama:
/apps/internal-search/
altında gereksiz crawl URL’leri oluşturuyorsa:
Disallow: /apps/internal-search/kuralı kullanılabilir.
Ancak uygulamanın storefront üzerinde kritik kaynakları aynı dizinden sunup sunmadığını kontrol etmek gerekir.
Örneğin JS, CSS veya render için gerekli kaynaklar yanlışlıkla engellenirse Google sayfayı doğru işleyemeyebilir.
Bu nedenle klasör seviyesinde engelleme URL crawl verisi incelendikten sonra yapılmalıdır.
Allow Kuralı Ne Zaman Kullanılır?
Bazen geniş bir klasörü engellerken belirli alt URL’lerin taranmasına izin vermek isteyebilirsiniz.
Örneğin:
Disallow: /example/
Allow: /example/public-page
mantığı kullanılabilir.
Ancak Allow ve Disallow kurallarında crawler davranışının user-agent’a göre değişebileceğini unutmamak gerekir.
Bu nedenle özellikle Google için oluşturulan kuralı robots.txt tester veya canlı URL testiyle doğrulamak önemlidir.
Shopify Search Sayfaları Engellenmeli mi?
Burada güncel Shopify davranışına dikkat etmek gerekir.
Shopify’ın resmi dokümantasyonuna göre bazı eski robots.txt.liquid custom template’leri artık varsayılan robots.txt dosyasında bulunmayan:
Disallow: /search
veya
Disallow: /policies/
gibi kuralları çıktılamaya devam edebilir.
Bu nedenle yıllar önce robots.txt.liquid oluşturduysanız güncel Shopify default yapısıyla karşılaştırmak önemlidir.
Eski custom template’i sürdürmek bazen artık gerekli olmayan kuralları mağazada tutabilir.
Koleksiyon Filtreleri Robots.txt ile Engellenmeli mi?
Shopify varsayılan olarak bazı filtre kombinasyonlarını zaten engeller.
Örneğin:
Disallow: /collections/*+*
Disallow: /collections/*sort_by*
gibi kurallar duplicate filtre ve sıralama URL’lerinin taranmasını sınırlar.
Bu nedenle filtre sistemine yeni ve agresif robots kuralları eklemeden önce mevcut çıktıyı kontrol edin.
Özellikle Shopify Search & Discovery kullanıyorsanız filtre URL yapılarının nasıl oluştuğunu crawler üzerinden incelemek daha doğru olur.
Shopify Search & Discovery rehberimizde anlattığımız gibi bazı ticari filtre kombinasyonları ayrı koleksiyon olarak ele alınabilirken çoğu filtre URL’sinin indexlenmesi gerekli değildir.
Sort_by URL’leri Engellenmeli mi?
Shopify bunu zaten varsayılan yapıda yönetiyor.
Örneğin:
?sort_by=price-ascending
veya
?sort_by=best-selling
gibi URL’ler aynı koleksiyon içeriğini yalnızca farklı sırada gösterir.
Shopify Disallow: /collections/*sort_by* kuralıyla bu tür sıralanmış koleksiyon URL’lerinin taranmasını sınırlar.
Bu nedenle ayrıca canonical veya noindex eklemek çoğu mağazada gerekli değildir.
UTM Parametrelerini Robots.txt ile Engellemek Doğru mu?
Genellikle hayır.
Örneğin:
?utm_source=instagram
parametreli URL’ler kampanya ölçümü için kullanılır.
Bu URL’leri robots.txt üzerinden agresif şekilde engellemek yerine canonical etiketi temiz ürün URL’sine işaret etmelidir.
Shopify canonical URL rehberimizde anlattığımız gibi tracking parametreleri için canonical daha uygun bir çözümdür.
Robots.txt’nin amacı analytics parametrelerini temizlemek değildir.
Cart ve Checkout Neden Robots.txt ile Engelleniyor?
Cart ve checkout URL’leri kullanıcıya özel ve arama sonuçları açısından değersiz sayfalardır.
Shopify bu nedenle varsayılan dosyada /cart/, /checkout ve /checkouts/ gibi yolları crawl dışı bırakır.
Bu kuralları kaldırmak SEO avantajı sağlamaz.
Aksine crawler’ın ürün ve koleksiyonlar yerine gereksiz işlem URL’lerine zaman harcamasına neden olabilir.
Account ve Order Sayfaları Neden Engelleniyor?
Müşteri hesabı ve sipariş sayfaları bireysel kullanıcıya özeldir.
Shopify varsayılan robots.txt dosyasında /account ve /orders yollarını bu nedenle engeller.
Bu sayfaların organik arama sonucu olması istenmez.
Dolayısıyla bu kuralları kaldırmak normal bir mağazada anlamlı değildir.
Robots.txt ile Sayfayı Google’dan Kaldırabilir miyim?
Hayır, robots.txt bunun için güvenilir araç değildir.
Bir sayfa daha önce indexlendiyse ve daha sonra robots.txt ile engellenirse Google sayfanın içeriğine erişemediği halde URL’yi arama sonuçlarında tutabilir.
Search Console’da:
Indexed, though blocked by robots.txt
benzeri mesaj görülebilir.
Shopify da bunun normal olabileceğini ve çoğu durumda aksiyon gerektirmediğini belirtiyor.
Sayfanın indexlenmesini istemiyorsanız crawler’ın sayfayı görebilmesi ve noindex etiketini okuyabilmesi gerekir.
Robots.txt ile Noindex Arasındaki Fark Nedir?
Robots.txt:
Crawler’ın URL’yi taramasını sınırlar.
Noindex:
Arama motoruna sayfayı indexleme mesajı verir.
Bu iki yöntem farklı amaçlara sahiptir.
Örneğin düşük değerli ancak crawler’ın erişmesi gereken bir sayfayı index dışı bırakmak istiyorsanız noindex kullanılabilir.
Crawler’ın hiçbir şekilde erişmesine gerek olmayan sepet veya admin gibi alanlarda robots.txt daha uygundur.
Robots.txt ile Canonical Arasındaki Fark Nedir?
Canonical duplicate içeriklerin ana URL’sini belirtir.
Robots.txt crawler erişimini yönetir.
Örneğin ürün:
/collections/ayakkabi/products/sneaker
URL’sinden açılıyor ancak ana URL:
/products/sneaker
ise çözüm robots.txt değildir.
Canonical etiketi ana ürün URL’sine işaret etmelidir.
Bu nedenle robots.txt’yi duplicate content çözümü olarak aşırı kullanmak doğru değildir.
robots.txt Sitemap İçerebilir mi?
Evet.
Robots.txt dosyasında sitemap URL’si belirtilebilir.
Shopify’ın robots.txt yapısında sitemap bilgisi rule group yapısının bir parçası olarak desteklenir. Ayrıca custom robots.txt üzerinden ekstra sitemap URL’leri eklenebilir.
Ancak standart Shopify mağazasında native sitemap zaten:
/sitemap.xml
adresindedir ve ekstra sitemap tanımlamaya çoğu zaman ihtiyaç yoktur.
Shopify sitemap rehberimizde anlattığımız gibi Shopify sitemap otomatik güncellendiği için standart mağazada manuel sitemap yönetimi gerekmez.
Belirli Bir Bot Nasıl Engellenir?
robots.txt user-agent bazlı çalışabilir.
Örneğin teorik olarak:
User-agent: ExampleBot
Disallow: /
ile belirli crawler’a bütün site için engel koyabilirsiniz.
Shopify da custom robots.txt üzerinden belirli crawler’ların engellenebileceğini belirtiyor.
Ancak bütün botlar robots.txt kurallarına uymak zorunda değildir.
Bu dosya daha çok iyi niyetli crawler’lara yönelik bir talimattır.
AI Botları Shopify Robots.txt ile Engellenebilir mi?
Belirli AI crawler user-agent’ları robots.txt üzerinden engellenebilir.
Shopify’ın güncel dokümantasyonu da AI crawler erişiminin /robots.txt katmanında yönetilebildiğini belirtiyor.
Ancak burada önemli bir ayrım var.
Shopify Agentic Storefronts üzerinden ürün veriniz Shopify Catalog aracılığıyla ChatGPT, Copilot veya diğer agentic commerce kanallarına gönderiliyorsa bu veri paylaşımı robots.txt’den bağımsız çalışabilir. Shopify da robots.txt üzerinden AI crawler engellemenin Shopify Catalog’dan agentic storefront’lara gönderilen ürün verisini durdurmadığını açıkça belirtiyor.
Shopify Agentic Commerce rehberimizde anlattığımız gibi open-web crawler erişimi ile commerce catalog dağıtımı farklı sistemlerdir.
Crawl-delay Eklemek Mantıklı mı?
Shopify custom robots.txt üzerinde belirli crawler’lar için crawl-delay kuralları eklenmesine izin veriyor.
Ancak bunu yalnızca gerçek bir bot yükü problemi varsa değerlendirmek gerekir.
Googlebot gibi bazı crawler’lar crawl-delay direktifini robots.txt içerisinde dikkate almayabilir.
Bu nedenle mağaza yavaş diye rastgele crawl-delay eklemek doğru çözüm değildir.
Önce bot trafiğinin gerçekten performans problemi oluşturduğu doğrulanmalıdır.
Googlebot Engellenmeli mi?
Normal bir Shopify mağazasında kesinlikle hayır.
Örneğin şu kural:
User-agent: Googlebot
Disallow: /
Google’ın mağazanızı taramasını durdurur ve organik görünürlüğünüzü ciddi şekilde etkileyebilir.
Shopify da robots.txt.liquid özelliğinin yanlış kullanımının tüm organik trafiğin kaybedilmesine yol açabileceği konusunda açık uyarı yapıyor.
Bu nedenle user-agent seviyesinde engelleme yapılırken özellikle dikkatli olunmalıdır.
robots.txt Değişiklikleri Ne Zaman Aktif Olur?
Shopify’da yayınlanan temadaki robots.txt.liquid dosyasında yapılan değişiklikler hemen /robots.txt çıktısına yansır.
Ancak Google veya başka crawler’ın yeni kuralı fark etmesi hemen olmayabilir.
Crawler robots.txt dosyasını tekrar çektiğinde yeni kurallar uygulanmaya başlar.
Bu nedenle değişiklik sonrası birkaç dakika içinde Search Console raporlarının tamamen değişmesini beklememek gerekir.
Robots.txt Değişiklikleri Nasıl Test Edilir?
İlk olarak:
https://domaininiz.com/robots.txt
adresini açın ve kuralın gerçekten çıktılandığını doğrulayın.
Daha sonra Google’ın robots.txt test araçları veya URL Inspection üzerinden belirli URL’nin crawl durumunu kontrol edebilirsiniz.
Shopify da değişikliklerin test edilmesini öneriyor.
Ayrıca Screaming Frog üzerinden robots.txt kuralları dikkate alınarak crawl yapabilir ve hangi URL’lerin blocked olduğunu görebilirsiniz.
Screaming Frog rehberimizde anlattığımız gibi büyük mağazada tek tek URL test etmek yerine crawl üzerinden pattern bazlı kontrol daha sağlıklı sonuç verir.
Search Console’da Blocked by Robots.txt Ne Demek?
Google URL’yi biliyor ancak robots.txt nedeniyle içeriğini crawl edemiyor demektir.
Bu durum her zaman hata değildir.
Örneğin:
/cart
veya checkout URL’leri blocked görünüyorsa bu beklenen davranıştır.
Ancak:
/products/ana-urun
gibi indexlenmesini istediğiniz önemli ürün URL’si blocked görünüyorsa robots.txt kurallarını kontrol etmek gerekir.
Önemli olan URL türünü değerlendirmektir.
Indexed Though Blocked by Robots.txt Hata mı?
Her zaman değil.
Google bir URL’yi başka sayfalardan veya sitemap dışı kaynaklardan keşfedip robots.txt nedeniyle içeriğini tarayamıyorsa URL yine indexlenebilir.
Shopify da bu mesajın default robots.txt ile engellenmesi gereken sayfalarda normal olabileceğini belirtiyor.
Örneğin account veya checkout URL’lerinde bu mesaj görülebilir.
Ancak ürün ve koleksiyon gibi ana SEO sayfalarında görülüyorsa inceleme gerekir.
Shopify robots.txt.liquid Tema Değişiminde Taşınır mı?
Burada önemli bir detay vardır.
Shopify’ın güncel dokümantasyonuna göre ThemeKit veya komut satırı üzerinden yapılan tema değişiklikleri robots.txt.liquid dosyasını koruyabilir. Ancak Shopify Admin’deki Themes bölümünden yüklenen yeni tema robots.txt.liquid dosyasını otomatik olarak içe aktarmayabilir.
Bu nedenle tema değişiminde robots.txt customizasyonunun yeni temada bulunup bulunmadığı mutlaka kontrol edilmelidir.
Tema migrasyonu sonrasında /robots.txt çıktısını tekrar açmak basit ama önemli bir kontroldür.
Eski Robots.txt.liquid Dosyası Sorun Yaratabilir mi?
Evet.
Shopify’ın default robots.txt dosyası zaman içinde güncellenebilir.
Eski bir robots.txt.liquid template varsayılan rule gruplarını eski biçimde çıktılamaya devam edebilir ve güncel default yapıdan farklı kurallar içerebilir.
Shopify özellikle eski custom template’lerde artık güncel default dosyada yer almayan /search ve /policies/ engellerinin kalabileceğini belirtiyor.
Bu nedenle robots.txt.liquid yıllar önce oluşturulduysa güncel Shopify default dosyasıyla karşılaştırılmalıdır.
Varsayılan Shopify Robots.txt Dosyasına Nasıl Geri Dönülür?
Custom robots.txt düzenlemesine artık ihtiyacınız yoksa robots.txt.liquid dosyasını silebilirsiniz.
Shopify Admin’de:
Online Mağaza > Temalar > Kodu Düzenle
alanına gidin.
robots.txt.liquid dosyasını bulun.
Dosyaya sağ tıklayıp:
Kalıcı olarak sil
seçeneğini kullanın.
Shopify daha sonra varsayılan robots.txt dosyasını tekrar kullanmaya başlar.
Bu, eski ve karmaşık custom kuralları temizlemek için bazen en sağlıklı çözümdür.
Shopify robots.txt ve Crawl Budget İlişkisi
Robots.txt özellikle büyük kataloglarda crawl verimliliği açısından önem kazanır.
50.000 ürünlü bir mağazada her ürün için filtre, sorting ve parametre kombinasyonları oluşuyorsa crawler’ın gereksiz URL’lere zaman harcaması mümkündür.
Shopify’ın varsayılan robots kuralları zaten bunun önemli bölümünü azaltır.
Ancak uygulamalar tarafından üretilen binlerce custom URL varsa ek inceleme gerekebilir.
Küçük bir mağazada ise crawl budget gerekçesiyle aşırı robots optimizasyonu yapmak çoğu zaman gereksizdir.
Robots.txt Teknik SEO’da Tek Başına Yeterli mi?
Hayır.
Robots.txt yalnızca crawl kontrol katmanıdır.
Sağlıklı Shopify teknik SEO yapısında ayrıca:
- canonical URL’ler
- sitemap
- noindex
- 301 redirect’ler
- iç linkleme
- hreflang
- HTTP status kodları
- structured data
- site hızı
birlikte değerlendirilmelidir.
Shopify teknik SEO rehberimizde anlattığımız gibi bir URL problemini yanlış araçla çözmek yeni SEO sorunları üretebilir.
Örnek Shopify Robots.txt Senaryosu
Örneğin mağazanızdaki özel bir uygulama:
/apps/lookbook-preview/
altında binlerce geçici URL üretiyor ve bu URL’ler Google tarafından sürekli crawl ediliyor olsun.
Öncelikle Screaming Frog ve Search Console üzerinden URL pattern’ini doğrulayın.
Bu sayfaların kullanıcı için organik arama değeri olmadığını ve crawler tarafından erişilmesinin gerekmediğini belirledikten sonra ilgili URL pattern’i robots.txt üzerinden engellenebilir.
Ancak aynı uygulama bu dizinden ürün sayfasının render edilmesi için kritik dosyalar sunuyorsa doğrudan klasör seviyesinde block yapmak yanlış olabilir.
Bu nedenle robots.txt kuralı site mimarisini anlayarak verilmelidir.
Shopify Robots.txt Düzenlerken Sık Yapılan Hatalar
En büyük hata varsayılan Shopify dosyasını tamamen silip internetten bulunan genel robots.txt şablonunu yapıştırmaktır.
İkinci hata duplicate URL sorununu robots.txt ile çözmeye çalışmaktır.
Üçüncü hata Google’dan kaldırılmak istenen URL’yi robots.txt ile engelleyip noindex’in okunmasını imkânsız hale getirmektir.
Dördüncü hata filtre URL’lerinin Shopify tarafından zaten engellenip engellenmediğini kontrol etmeden yeni kurallar eklemektir.
Beşinci hata /products/, /collections/ veya /blogs/ gibi önemli dizinleri yanlışlıkla block etmektir.
Altıncı hata yeni tema geçişinde robots.txt.liquid dosyasını kontrol etmemektir.
Yedinci hata robots.txt değişikliği sonrası canlı dosyayı ve Search Console’u test etmemektir.
Shopify Robots.txt Kontrol Listesi
Robots.txt audit sırasında şu alanları kontrol edin:
domain.com/robots.txtaçılıyor mu?- Mağaza Shopify’ın güncel default kurallarını kullanıyor mu?
- robots.txt.liquid custom template mevcut mu?
- Custom template gerçekten gerekli mi?
- Ürün URL’leri yanlışlıkla engelleniyor mu?
- Koleksiyon URL’leri yanlışlıkla engelleniyor mu?
- Blog ve sayfalar crawl edilebilir mi?
- Cart ve checkout engelleniyor mu?
- Account ve order URL’leri engelleniyor mu?
- Filter URL’leri doğru yönetiliyor mu?
sort_byURL’leri engelleniyor mu?- Custom app URL’leri gereksiz crawl üretiyor mu?
- Sitemap referansı doğru mu?
- Googlebot veya diğer önemli crawler’lar yanlışlıkla tamamen engellenmiş mi?
- AI crawler kuralları varsa gerçekten amaçlanan sonucu veriyor mu?
- Search Console’daki blocked URL’ler beklenen URL türleri mi?
- Tema değişiminden sonra robots.txt.liquid korunmuş mu?
- Eski robots.txt kuralları hâlâ gereksiz şekilde aktif mi?
Shopify robots.txt düzenlemesinde en iyi yaklaşım mümkün olduğunca az müdahaledir. Shopify’ın varsayılan dosyası zaten e-ticaret mağazalarında taranması gereksiz olan çok sayıda URL türünü yönetir. Bu nedenle custom robots.txt ancak gerçek crawl verisiyle doğrulanmış özel bir ihtiyaç varsa kullanılmalıdır.
Doğru robots.txt yapısı, Google’ın ürün ve koleksiyon gibi değerli sayfalara daha rahat odaklanmasına yardımcı olabilir. Yanlış yapı ise tam tersine mağazanın en önemli sayfalarını arama motorlarından uzaklaştırabilir.
Shopify Robots.txt ve Teknik SEO İçin Roi Digital Shopify Danışmanlığı
Roi Digital olarak Shopify robots.txt çalışmalarında doğrudan kural eklemekle başlamıyoruz. Önce Search Console, crawl verileri, canonical yapısı, sitemap, filtre URL’leri ve uygulama kaynaklı URL pattern’lerini analiz ederek problemin gerçekten crawl kontrolünden kaynaklanıp kaynaklanmadığını belirliyoruz.
Gerekli durumlarda robots.txt.liquid yapısını Shopify’ın güncel varsayılan kurallarını koruyacak şekilde düzenliyor; teknik SEO sorunlarının canonical, noindex veya yönlendirme gibi daha doğru yöntemlerle çözülmesi gereken noktalarında robots.txt kullanımından kaçınıyoruz.
Detaylı bilgi için Roi Digital Shopify Danışmanlığı sayfasını inceleyebilirsiniz.
Kaynaklar
Shopify robots.txt.liquid Düzenleme – Shopify Yardım Merkezi