

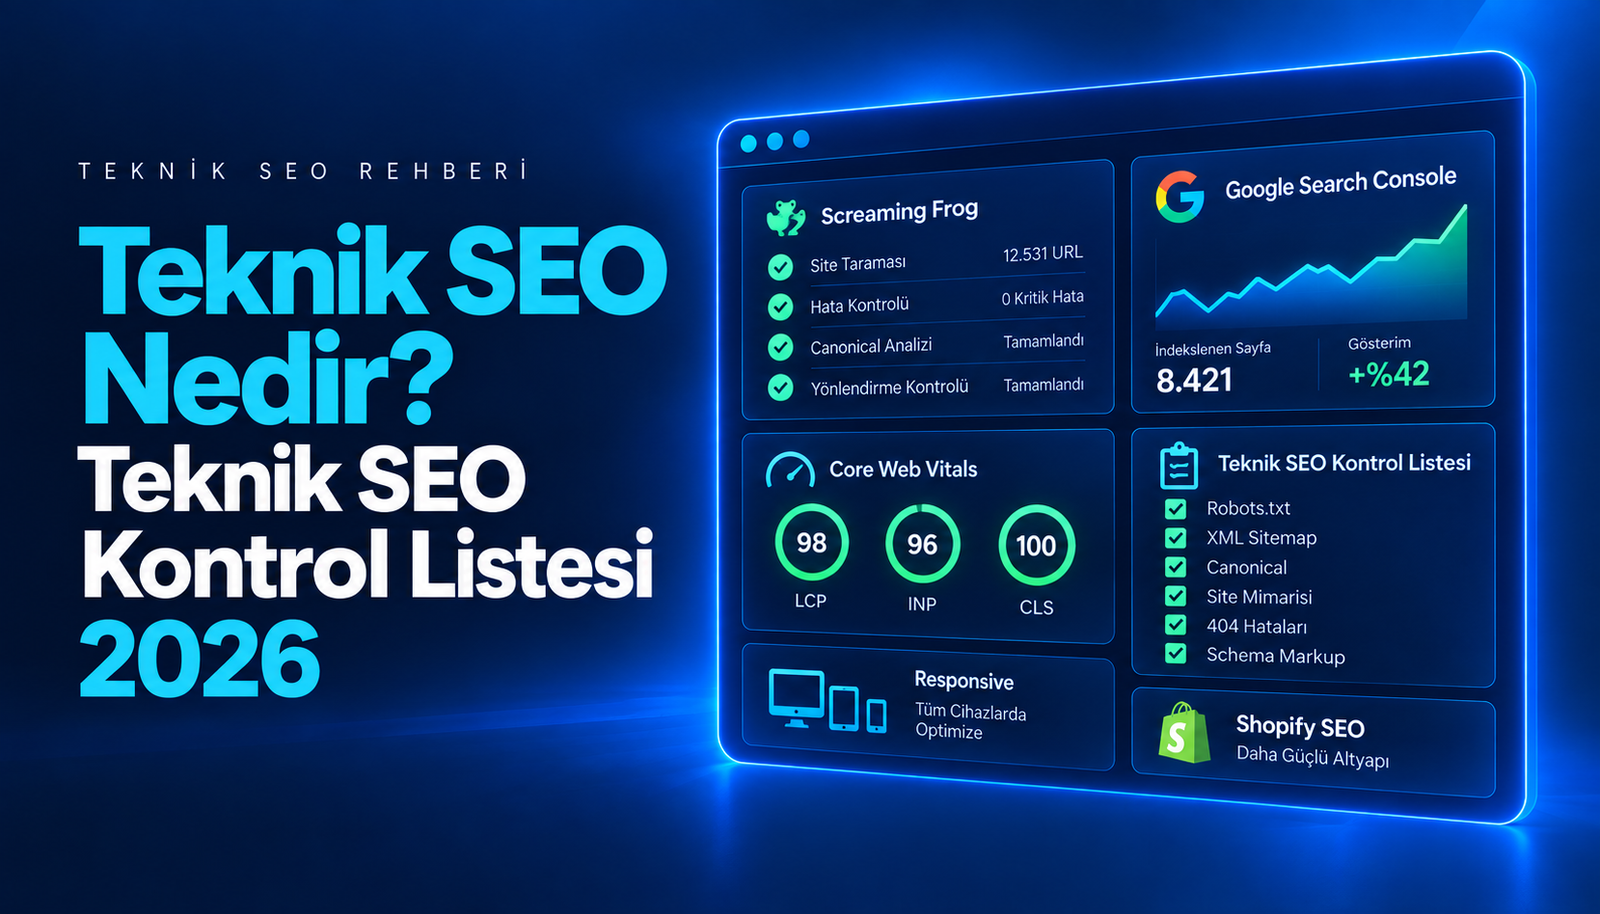

Teknik SEO, arama motorlarının bir web sitesini doğru şekilde tarayabilmesi, sayfaları anlayabilmesi, hangi URL’lerin indekslenmesi gerektiğini belirleyebilmesi ve içeriği kullanıcıya mümkün olduğunca sorunsuz sunabilmesi için yapılan teknik optimizasyonların bütünüdür.
İçerik ne kadar güçlü olursa olsun Googlebot sayfaya ulaşamıyorsa, yanlış canonical nedeniyle başka bir URL ana sayfa olarak seçiliyorsa veya önemli sayfalar site mimarisinin çok derininde kalıyorsa içerik potansiyelinin tamamını kullanamayabilir. Teknik SEO’nun görevi bu engelleri ortadan kaldırmaktır.
Bu nedenle teknik SEO yalnızca robots.txt veya sitemap kontrolünden ibaret değildir. İndeksleme, canonicalizasyon, HTTP durum kodları, dahili bağlantılar, site mimarisi, Core Web Vitals, yapılandırılmış veri, JavaScript rendering ve crawl yönetimi birlikte değerlendirilmelidir.
Teknik SEO çalışmasının nihai hedefi hata raporunda sıfır uyarı görmek değil, arama motorlarının önemli sayfaları kolayca keşfedebildiği, kullanıcıların rahat gezinebildiği ve gereksiz URL’lerin sistemi karmaşıklaştırmadığı bir yapı oluşturmaktır.
Teknik SEO Nedir?
Teknik SEO, web sitesinin arama motorlarıyla kurduğu teknik iletişimi optimize eder. Google bir siteyi ziyaret ettiğinde önce URL’leri keşfeder, tarar, gerekirse JavaScript’i işler, içeriği değerlendirir ve uygun gördüğü sayfaları indeksleme sistemine dahil eder.
Bu sürecin herhangi bir aşamasında problem oluşabilir.
Örneğin önemli bir kategori sayfası robots.txt tarafından engellenmiş olabilir. Sayfa taranabilir ancak noindex etiketi taşıyor olabilir. İki benzer URL birbirinden farklı canonical sinyalleri verebilir. JavaScript ile oluşturulan ana içerik Google’ın ilk HTML yanıtında bulunmayabilir. Site içinde hiçbir bağlantı almayan önemli bir sayfa ise arama motorunun gözünde düşük öncelikli kalabilir.
Bu nedenle teknik SEO’daki temel sorular şunlardır:
- Google önemli URL’leri bulabiliyor mu?
- Bulduğu URL’leri tarayabiliyor mu?
- Taradığı sayfaları doğru şekilde render edebiliyor mu?
- Hangi URL’nin canonical olduğunu anlayabiliyor mu?
- İndekslenmesi gereken sayfalar gerçekten indekslenebilir mi?
- Gereksiz URL’ler Google’ın zamanını tüketiyor mu?
- Site mimarisi önemli sayfalara yeterli bağlantı gücü aktarıyor mu?
- Sayfalar mobil cihazlarda hızlı ve kullanılabilir mi?
Teknik SEO çalışması bu soruların her birini sistematik biçimde cevaplamalıdır.
Teknik SEO Neden Önemlidir?
Teknik SEO sorunlarının en önemli özelliği, sitenin tamamını veya büyük URL gruplarını aynı anda etkileyebilmesidir.
Bir blog yazısındaki zayıf paragraf tek bir içeriğin performansını etkileyebilir. Ancak yanlış robots.txt kuralı yüzlerce sayfanın taranmasını engelleyebilir. Hatalı canonical şablonu bütün ürün sayfalarında yanlış URL’nin tercih edilmesine neden olabilir.
Özellikle e-ticaret, haber, ilan ve büyük içerik sitelerinde küçük bir şablon hatasının binlerce URL’ye yayılması mümkündür.
Teknik SEO aynı zamanda diğer SEO çalışmalarının temelini oluşturur. Shopify SEO, içerik optimizasyonu veya backlink çalışması yapılmadan önce arama motorlarının hedef sayfalara teknik olarak erişebilmesi gerekir.
İyi teknik yapı sıralama garantisi sağlamaz. Ancak teknik problemler güçlü içeriklerin görünürlük kazanmasını engelleyebilir.
Teknik SEO Nasıl Yapılır?
Teknik SEO çalışmasına rastgele hata arayarak başlanmamalıdır. Önce sitenin URL envanteri ve indeksleme yapısı anlaşılmalıdır.
Pratik bir teknik SEO denetimi şu sırayla ilerleyebilir:
- Site Screaming Frog veya benzeri crawler ile taranır.
- Google Search Console indeksleme verileri incelenir.
- Robots.txt ve sitemap dosyaları kontrol edilir.
- HTTP durum kodları ayrıştırılır.
- Canonical ve indexability sorunları tespit edilir.
- Site mimarisi ve crawl depth analiz edilir.
- Core Web Vitals ve mobil performans kontrol edilir.
- Structured data doğrulanır.
- JavaScript ağırlıklı sayfalarda rendered HTML ayrıca incelenir.
- Sorunlar önem ve ticari etkiye göre önceliklendirilir.
Burada hata sayısını azaltmaktan çok doğru hatayı düzeltmek önemlidir. Satış üreten bir sayfanın yanlış canonical etiketi, yüzlerce düşük değerli görsel uyarısından daha yüksek önceliğe sahip olabilir.
Robots.txt Nasıl Optimize Edilir?
Robots.txt dosyası arama motoru botlarının sitenin hangi bölümlerini tarayabileceğini kontrol eder. Dosya sitenin kök dizininde bulunmalıdır:
https://siteadi.com/robots.txt
Google robots.txt içerisinde temel olarak User-agent, Allow, Disallow ve Sitemap direktiflerini destekler. Google ayrıca crawl-delay direktifini desteklemediğini açıkça belirtir.
Basit bir örnek:
User-agent: *
Disallow: /arama/
Disallow: /hesabim/

Sitemap: https://siteadi.com/sitemap.xml
Ancak robots.txt dosyasını optimize etmek, mümkün olduğunca fazla URL’yi engellemek anlamına gelmez.
Önce hangi URL’lerin gerçekten gereksiz crawl oluşturduğunu tespit etmek gerekir. Örneğin site içi arama sonuçları, sonsuz filtre kombinasyonları veya teknik yönetim URL’leri botların gereksiz yere taradığı alanlar olabilir.
En kritik hata ise robots.txt dosyasını indeks kaldırma aracı olarak kullanmaktır. Google, robots.txt ile engellenen bir URL’nin içeriğini tarayamaz ancak URL’yi başka kaynaklardan keşfederse adresin kendisi yine arama sonuçlarında görünebilir.
Bir sayfanın indekslenmesini istemiyorsanız çoğu durumda noindex daha doğru çözümdür. Ancak Google’ın noindex etiketini görebilmesi için sayfayı tarayabilmesi gerekir.
Bu nedenle şu kombinasyondan kaçınılmalıdır:
Disallow: /ornek-sayfa/
ve aynı sayfanın HTML’inde:
<meta name="robots" content="noindex">
Google sayfayı tarayamıyorsa noindex direktifini göremeyebilir.
Robots.txt değişikliğinden sonra mutlaka önemli sayfaların yanlışlıkla engellenmediğini kontrol edin. Özellikle CSS ve JavaScript kaynaklarını gereksiz yere engellemek Google’ın sayfayı doğru render etmesini zorlaştırabilir.
XML Sitemap Nasıl Oluşturulur ve Kontrol Edilir?
XML sitemap, arama motorlarına hangi URL’lerin önemli olduğunu bildirmek için kullanılan dosyadır. Sitemap bir URL’nin indeksleneceğini garanti etmez ancak keşif sürecini kolaylaştırabilir.
İyi bir sitemap içerisinde yalnızca indekslenmesini istediğiniz canonical URL’ler bulunmalıdır.
Örneğin aşağıdaki URL türlerinin sitemap içerisinde yer almaması gerekir:
- 404 sayfalar
- 301 veya 302 yönlendiren URL’ler
- Noindex sayfalar
- Canonical etiketi başka URL’yi gösteren sayfalar
- Gereksiz parametreli URL’ler
Büyük sitelerde sitemap dosyalarını URL türlerine göre ayırmak analiz açısından faydalıdır:
/sitemap-posts.xml
/sitemap-pages.xml
/sitemap-products.xml
/sitemap-categories.xml
Böylece Search Console’da örneğin ürün sayfalarının mı yoksa blog URL’lerinin mi indeksleme problemi yaşadığı daha kolay görülebilir.
Sitemap kontrolünde yalnızca dosyanın açılıp açılmadığına bakmayın. İçindeki URL’leri crawler ile tarayın ve her URL’nin durum kodunu kontrol edin.
Sağlıklı bir sitemap URL’si genel olarak:
- 200 durum kodu dönmeli
- Indexable olmalı
- Canonical kendisini göstermeli
- Robots.txt tarafından engellenmemeli
Site taşınması veya URL değişikliğinde sitemap dosyasının yeni URL’lerle güncellenmesi gerekir. Google da site taşıma süreçlerinde sitemap’in yeni URL’lerle güncellenmesini öneriyor.
Canonical Etiketi Nasıl Kullanılır?
Canonical etiketi, aynı veya çok benzer içeriğe sahip birden fazla URL olduğunda hangi URL’nin temsilci sürüm olarak tercih edildiğini belirtir.
Örnek:
<link rel="canonical" href="https://siteadi.com/urun/" />
Canonical özellikle şu durumlarda önem kazanır:
- Filtre URL’leri
- Sıralama parametreleri
- UTM parametreleri
- Ürün varyantları
- HTTP / HTTPS varyasyonları
- www / non-www yapıları
- Benzer içerikli URL’ler
Google canonical sinyalini zorunlu bir talimat olarak değil güçlü bir sinyal olarak değerlendirir. Redirect, sitemap, internal link ve rel="canonical" gibi birden fazla sinyal birlikte canonical seçiminde rol oynar.
Örneğin ana URL:
ve parametreli sürüm:
ise parametreli sayfanın canonical etiketi ana kategoriye işaret edebilir.
Ancak canonical etiketlerini otomatik olarak her sayfayı ana sayfaya gösterecek şekilde kullanmak ciddi hatadır.
Her sayfanın canonical hedefi içerik açısından mantıklı olmalıdır.
Canonical kontrolünde şu sinyalleri birlikte değerlendirin:
- HTML canonical
- Sitemap URL’si
- Dahili link hedefi
- HTTP yönlendirmeleri
- Search Console’daki Google-selected canonical
Google sizin belirlediğiniz canonical yerine başka URL seçiyorsa Search Console URL Inspection ile bunun nedenini araştırabilirsiniz.
JavaScript kullanan sitelerde canonical’ın yalnızca rendered HTML sonrası oluşması da ayrıca kontrol edilmelidir. Screaming Frog, raw HTML ile rendered HTML arasındaki canonical farklılıklarını tespit edebilir.
Site Mimarisi SEO İçin Nasıl Oluşturulur?
Site mimarisi, sayfaların birbirleriyle nasıl bağlandığını ve kullanıcının önemli içeriğe kaç adımda ulaşabildiğini belirler.
İyi bir yapı genellikle şu mantığa yakındır:
Ana Sayfa
   ↓
Ana Kategori
   ↓
Alt Kategori
   ↓
Ürün / İçerik
Burada amaç her sayfanın ana sayfadan tam olarak üç tıklama uzakta olması değildir. Asıl amaç önemli sayfaların gereksiz derinlikte kalmamasıdır.
Örneğin önemli hizmet sayfasına yalnızca eski bir blog yazısının içerisinden ulaşılabiliyorsa teknik olarak indekslenebilir olsa bile mimari açıdan zayıf bir konumdadır.
Kategori, alt kategori ve detay sayfaları arasında doğal bir hiyerarşi oluşturulmalıdır.
Breadcrumb bu yapının kullanıcıya görünür hale gelmesine yardımcı olabilir:
Ana Sayfa > SEO > Teknik SEO
Breadcrumb yalnızca kullanıcı navigasyonu için değil, sayfanın site içindeki bağlamını anlamayı kolaylaştıran yapısal bir öğedir. Google breadcrumb structured data desteği de sunar.
Site mimarisi hazırlanırken önemli sayfaların crawl depth değerleri Screaming Frog üzerinden kontrol edilebilir. Çok önemli bir kategori 6-7 tıklama derinliğindeyse menü, kategori yapısı veya iç linkleme yeniden değerlendirilebilir.
404 Hataları ve Yönlendirmeler Nasıl Yönetilir?
404 sayfası tek başına SEO hatası değildir. Gerçekten kaldırılmış ve alternatifi bulunmayan bir URL’nin 404 döndürmesi normaldir.
Sorun, aktif site içerisinde kullanıcıların ve botların sürekli 404 sayfalarına yönlendirilmesidir.
İlk olarak 404 URL’leri üç gruba ayırın:
Alternatifi bulunan sayfalar: İlgili yeni URL’ye 301 yönlendirme yapılabilir.
Yanlış dahili bağlantılar: Link doğrudan doğru URL’ye güncellenmelidir.
Kalıcı olarak silinen ve alternatifi bulunmayan içerikler: 404 veya 410 bırakılabilir.
Her 404 URL’yi ana sayfaya yönlendirmek doğru değildir. Örneğin kaldırılmış kırmızı spor ayakkabı ürününü ana sayfaya yönlendirmek kullanıcı niyeti açısından zayıf bir eşleşmedir.
Ürün artık yoksa en yakın kategori veya gerçek alternatif ürün bulunabilir. Hiçbir mantıklı alternatif yoksa 404 bırakılması daha doğru olabilir.
Yönlendirmelerde zincirlerden de kaçının.
Kötü yapı:
A → B → C → D
Daha iyi yapı:
A → D
Google site taşıma belgelerinde kalıcı yönlendirmelerin mümkün olduğunca doğrudan yeni URL’ye gitmesini ve iç linklerin de yeni hedeflerle güncellenmesini öneriyor.
Screaming Frog üzerinde Response Codes raporunu kullanarak 3xx ve 4xx URL’leri, ardından Inlinks sekmesinden bu URL’lere hangi sayfaların link verdiğini görebilirsiniz.
Core Web Vitals Nasıl İyileştirilir?
Core Web Vitals yalnızca hız skoru değildir. Kullanıcının sayfayı ne kadar hızlı gördüğünü, etkileşimlere ne kadar hızlı cevap aldığını ve sayfanın yüklenirken ne kadar stabil olduğunu ölçer.
Üç temel metrik:
LCP: Ana içeriğin görüntülenme süresi.
INP: Kullanıcı etkileşimine verilen yanıtın gecikmesi.
CLS: Sayfa yüklenirken oluşan beklenmedik görsel kaymalar.
Core Web Vitals problemi çözülürken önce hangi metriğin başarısız olduğu bulunmalıdır.
LCP kötü ise genellikle:
- Hero görseli
- Ana ürün görseli
- Sunucu yanıt süresi
- Render-blocking CSS
- Fontlar
- Kritik kaynağın geç keşfedilmesi
incelenmelidir.
INP kötü ise:
- Ağır JavaScript
- Uzun main-thread görevleri
- Üçüncü taraf scriptler
- Chat, popup veya analitik uygulamaları
kontrol edilmelidir.
CLS yüksekse:
- Width ve height belirtilmeyen görseller
- Sonradan açılan bannerlar
- Reklam alanları
- Dinamik widget’lar
incelenmelidir.
Responsive tasarım da burada önemlidir. Bir site mobil ekrana uyum sağlıyor olabilir ancak masaüstüne ait ağır görselleri ve scriptleri mobilde de yüklemeye devam ediyorsa gerçek mobil performans yine zayıf olabilir.
Schema Markup Nasıl Kullanılır?
Schema markup, sayfadaki bilgileri makine tarafından daha anlaşılır hale getiren yapılandırılmış veri biçimidir.
Schema doğrudan sıralama yükselten sihirli bir kod değildir. Ancak Google’ın sayfadaki varlıkları ve özellikleri daha net anlamasına yardımcı olabilir ve uygun sayfalarda rich result görünümlerine uygunluk sağlayabilir. Google, structured data’nın sayfa içeriğini anlamasına yardımcı olduğunu açıkça belirtir.
Kullanılabilecek schema türleri siteye göre değişir:
- Product
- Article
- Organization
- BreadcrumbList
- LocalBusiness
- Event
- Recipe
Örneğin bir e-ticaret ürün sayfasında Product schema kullanılabilirken blog yazısında Article daha anlamlıdır.
Schema ekledikten sonra Google Rich Results Test ile doğrulama yapılmalıdır. Google da structured data yayınlamadan önce Rich Results Test kullanılmasını ve ardından URL Inspection üzerinden Google’ın sayfayı nasıl gördüğünün kontrol edilmesini öneriyor.
En sık karşılaşılan hatalardan biri, sayfada kullanıcıya gösterilmeyen bilgilerin schema içerisinde eklenmesidir. Structured data sayfanın gerçek içeriğiyle tutarlı olmalıdır.
Bir başka problem de aynı schema’nın tema ve eklenti tarafından iki kez oluşturulmasıdır. Özellikle WordPress ve Shopify SEO uygulamalarında Product, Article veya Organization verisinin yinelenip yinelenmediği kontrol edilmelidir.
Crawl Budget Nasıl Optimize Edilir?
Crawl budget, Googlebot’un bir siteyi ne kadar ve ne sıklıkla tarayabileceğiyle ilgili kaynak yönetimini ifade eder.
Ancak burada önemli bir yanlış anlaşılma vardır: Her sitenin crawl budget optimizasyonu yapması gerekmez.
Google’ın güncel dokümantasyonu crawl budget rehberinin özellikle milyonlarca URL’ye sahip büyük siteler, 10.000’den fazla URL’si olup günlük değişen siteler veya Search Console’da çok sayıda Descubierta / currently not indexed benzeri URL bulunan siteler için önemli olduğunu belirtir.
Yüz sayfalık kurumsal bir site için crawl budget çoğu zaman gerçek problem değildir.
Büyük sitelerde ise şu problemler gereksiz crawl tüketebilir:
- Sonsuz filtre kombinasyonları
- Takvim URL’leri
- Site içi arama sayfaları
- Session parametreleri
- Yinelenen URL’ler
- Redirect zincirleri
- Soft 404 sayfalar
- Düşük değerli faceted navigation URL’leri
Crawl optimizasyonunda amaç Googlebot’u zorla daha hızlı çalıştırmak değildir. Botun önemli URL’lere daha fazla zaman ayırabilmesini sağlamaktır.
Bunun için gereksiz URL üretimini azaltmak, sağlam site mimarisi kurmak, sitemap’i güncel tutmak ve sunucu performansını korumak gerekir.
Teknik SEO Analizi Nasıl Yapılır?
Teknik SEO analizinde tek bir araç yeterli değildir.
Google Search Console, Google’ın gördüğü indeksleme problemlerini gösterir. Screaming Frog ise sitenin teknik yapısını crawler perspektifinden analiz eder. PageSpeed Insights performansı ölçerken Rich Results Test structured data tarafını kontrol eder.
Sağlıklı analiz için bu veriler birleştirilmelidir.
Örneğin Screaming Frog 10.000 URL bulmuş ancak Search Console yalnızca 2.000 URL’nin indekslendiğini gösteriyorsa şu sorular sorulmalıdır:
Neden kalan URL’ler indekslenmiyor?
Bunların indekslenmesi gerekiyor mu?
Canonical mı yanlış?
İç link almıyorlar mı?
Noindex mi taşıyorlar?
İçerikleri birbirine çok mu benziyor?
Teknik SEO denetiminin amacı rapor üretmek değil bu sorulara cevap vermektir.
Screaming Frog ile Teknik SEO Analizi Nasıl Yapılır?
Screaming Frog ile teknik SEO analizine sitenin ana domainini Spider modunda taratarak başlanabilir.
Tarama bittikten sonra ilk olarak Internal sekmesinden URL envanterini inceleyin. Daha sonra analiz aşamasını birkaç bölüme ayırın.
1. HTTP durum kodlarını kontrol edin
Response Codes bölümünde:
- 2xx
- 3xx
- 4xx
- 5xx
URL’leri ayrı ayrı inceleyin.
404 URL’lerde Inlinks alanından hatalı linkin hangi sayfada bulunduğunu bulun.
2. Canonical problemlerini kontrol edin
Canonicals bölümünde:
- Missing canonical
- Canonicalised URL
- Non-indexable canonical
- Multiple canonical
gibi durumları inceleyin.
Canonical hedefinin 404 veya redirect olmaması gerekir.
3. Indexability kontrolü yapın
Internal raporunda Indexability ve Indexability Status sütunlarını kullanın.
Önemli URL noindex ise bunun bilinçli olup olmadığını kontrol edin.
4. Title ve H1 yapılarını inceleyin
Duplicate title veya H1 her zaman kritik sorun değildir ancak benzer ticari sayfaların yanlışlıkla aynı metadata’yı kullandığını gösterebilir.
5. Crawl Depth analiz edin
Önemli sayfaların ana sayfadan kaç tıklama uzaklıkta olduğunu inceleyin.
Ticari açıdan önemli URL’lerin gereksiz yere derin seviyelerde kalması site mimarisinin zayıf olduğuna işaret edebilir.
6. Görselleri kontrol edin
Images raporundan çok büyük dosyaları tespit edin. Özellikle ürün ve hero görsellerinde birkaç megabaytlık dosyalar performans problemi oluşturabilir.
7. JavaScript rendering karşılaştırması yapın
JavaScript ağırlıklı bir site varsa Configuration > Spider > Rendering bölümünden JavaScript rendering açarak ikinci crawl yapılabilir.
Screaming Frog’un kendi dokümantasyonu da JavaScript ile oluşturulan içerikleri analiz etmek için JavaScript rendering modunun kullanılabileceğini belirtiyor.
Raw HTML ile rendered HTML arasında canonical, link veya içerik farkı varsa JavaScript SEO problemi olabilir.
8. Sitemap ve crawl verisini karşılaştırın
Sitemap içerisinde bulunan ancak crawler tarafından normal site navigasyonundan keşfedilemeyen URL’ler orphan page adayı olabilir.
Search Console, GA4 ve Screaming Frog URL listeleri birleştirilerek sitenin gerçek erişilebilirlik yapısı daha detaylı analiz edilebilir.
Teknik SEO Kontrol Listesi
Teknik SEO denetimi tamamlanırken aşağıdaki alanlar sistematik olarak kontrol edilebilir:
Tarama ve İndeksleme
- Robots.txt önemli URL’leri engelliyor mu?
- Noindex etiketleri doğru sayfalarda mı?
- Önemli sayfalar Google tarafından indekslenebilir mi?
- Site içi arama ve filtre URL’leri kontrol altında mı?
- JavaScript ile oluşturulan içerikler Google tarafından görülebiliyor mu?
Sitemap
- XML sitemap çalışıyor mu?
- Search Console’a gönderilmiş mi?
- Sitemap yalnızca 200 durum kodlu URL’lerden mi oluşuyor?
- Noindex veya canonicalised URL’ler sitemap içinde mi?
- Eski URL’ler sitemap’ten kaldırılmış mı?
Canonical
- Her önemli sayfada doğru canonical var mı?
- Canonical hedefleri 200 durum kodu döndürüyor mu?
- Google-selected canonical ile user-selected canonical arasında fark var mı?
- Parametreli URL’lerin canonical yapısı doğru mu?
Site Mimarisi
- Önemli sayfalar mantıklı kategori yapısında mı?
- Kritik sayfalar gereksiz crawl depth seviyesinde mi?
- Orphan page bulunuyor mu?
- Breadcrumb yapısı doğru mu?
- Menü ve dahili linkler gerçek HTML bağlantılarıyla oluşturulmuş mu?
HTTP Durum Kodları
- Kırık dahili linkler bulunuyor mu?
- 404 URL’ler doğru yönetiliyor mu?
- Redirect chain bulunuyor mu?
- Gereksiz 302 yönlendirmeler var mı?
- 5xx sunucu hataları bulunuyor mu?
Performans
- LCP sorunu var mı?
- INP değerleri sağlıklı mı?
- CLS problemi bulunuyor mu?
- Büyük görseller optimize edilmiş mi?
- Gereksiz JavaScript ve CSS azaltılmış mı?
- Responsive mobil deneyim hızlı ve kullanılabilir mi?
Structured Data
- Sayfa türüne uygun schema kullanılıyor mu?
- Schema verileri gerçek sayfa içeriğiyle uyuşuyor mu?
- Aynı structured data birden fazla kez oluşturuluyor mu?
- Rich Results Test hata gösteriyor mu?
Büyük Siteler İçin Crawl Yönetimi
- Gereksiz parametre URL’leri üretiliyor mu?
- Faceted navigation kontrol altında mı?
- Düşük değerli sayfalar crawl kaynaklarını tüketiyor mu?
- Sitemap güncel mi?
- Search Console’da çok sayıda keşfedildi ancak indekslenmedi URL’si bulunuyor mu?
Teknik SEO çalışmasında amaç tüm araçların yeşil rapor vermesi değildir. Asıl amaç Google’ın önemli sayfaları doğru şekilde keşfetmesi, taraması ve anlamasıdır. Bir teknik hata yalnızca araçta uyarı oluşturduğu için değil, crawl, index veya kullanıcı deneyimini gerçekten etkilediği zaman öncelikli hale gelir.
Bu nedenle teknik SEO analizi düzenli olarak tekrarlanmalıdır. Yeni tema, eklenti, URL değişikliği, site taşıma veya büyük içerik güncellemelerinden sonra yeniden crawl yapmak özellikle önemlidir. Shopify SEO gibi platforma özgü çalışmalarda da aynı prensip geçerlidir: önce gerçek problemi tespit edin, ardından yalnızca gerekli teknik müdahaleyi yapın.